Ein KI Avatar Video verwandelt ein Foto und eine kurze Sprachaufnahme in ein sprechendes, lippensynchrones Video – ohne Kamera, ohne Schauspieler und ohne Textprompt. VIBEs Talking-Avatar-Modell liest den Rhythmus einer hochgeladenen Audiodatei aus und animiert ein Standbild passend dazu, wodurch ein Clip im Sprecher-Stil in 480p oder 720p entsteht – in welcher Sprache auch immer die Aufnahme ist. Dieser Guide zeigt dir genau, was das Modell als Input braucht, was dabei herauskommt und wo ein KI Avatar Video neben VIBEs anderen Text-zu-Video- und Bild-zu-Video-Modellen seinen Platz hat.
VIBE ist eine KI-Video-Generator-App, mit der du beeindruckende Videos aus Textprompts oder Bildern erstellen kannst – mit den neuesten KI-Modellen wie Kling, Sora und Veo. Talking Avatar ist das eine Modell, das für genau eine Aufgabe gebaut wurde: ein Standbild in eine sprechende Person zu verwandeln, ohne dass dafür gefilmt wird.
Was ist ein KI Avatar Video und wie funktioniert es?
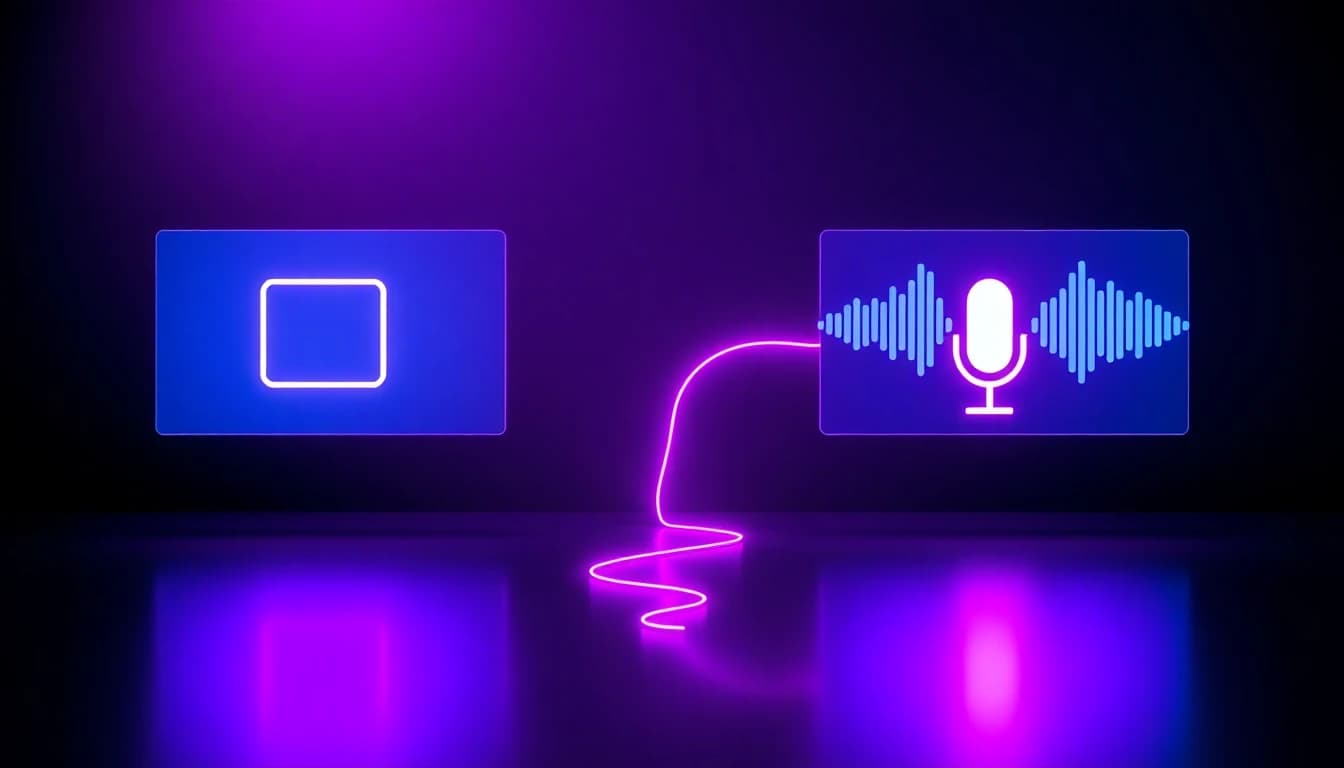
Ein KI Avatar Video ist ein Videogenerierungsmodell, das ein Foto eines Gesichts und eine separate Sprachaufnahme nimmt und dann Mund, Augen und Kopf passend zu diesem Audio animiert – so entsteht ein lippensynchrones, sprechendes Video. In VIBE ist das genau das Talking-Avatar-Modell, und es funktioniert anders als jedes andere Modell in der App: Es hat überhaupt kein Textprompt-Feld. Statt eine Szene in Worten zu beschreiben, lieferst du zwei Dateien – ein Foto und eine Audioaufnahme – und das Modell übernimmt den Rest.
Talking Avatar ist ein Premium-Modell und deshalb nicht Teil von VIBEs kostenloser Rotation, wie es bei manchen Text-zu-Video- und Bild-zu-Video-Modellen der Fall ist. Es rendert in 480p oder 720p, wobei 720p pro Generierung mehr Tokens kostet. Statt wie die meisten anderen Modelle von VIBE pro Sekunde abzurechnen, verlangt Talking Avatar eine feste Anzahl an Tokens pro Generierung – 35 Tokens bei 480p, 60 bei 720p – unabhängig davon, wie lang die Sprachaufnahme läuft. Das macht längere Skripte pro Sekunde fertigem Video effizienter als kürzere. Talking Avatar gehört zur gleichen Modell-Auswahl wie VIBEs andere KI-Videogeneratoren – lade VIBE herunter, um es an einem eigenen Skript auszuprobieren.
Ein KI Avatar Video braucht genau zwei Inputs und sonst nichts:
- Ein klares, frontal aufgenommenes Foto eines Gesichts – gutes Licht, keine Sonnenbrille, keine Verdeckung, da der Videorahmen später genau diesem Foto entspricht
- Eine Sprachaufnahme (Erzählung, ein Werbespot-Text, eine Kurs-Einleitung oder beliebiges gesprochenes Audio) als hochgeladene Datei – ihre Länge bestimmt die Länge des fertigen Clips
- Kein Text- oder Skript-Feld: Das Modell liest niemals Text, nur das Foto und das Audio
- Eine Auflösungswahl zwischen 480p und 720p, die du vor der Generierung triffst
Ist Talking Avatar dasselbe wie VIBEs andere KI-Video-Modelle?
Nein. Talking Avatar ist reines Bild-zu-Video und akzeptiert keinen Textprompt, während die meisten anderen Modelle von VIBE – darunter auch die in unserem Guide, wie du ein Selfie in ein Video verwandelst – ein Foto plus einen geschriebenen Prompt brauchen, der Bewegung, Kamerafahrt oder eine Szene beschreibt. Ein Standard-Bild-zu-Video-Modell animiert ein Foto nach dem, was du eintippst; Talking Avatar animiert ein Foto nach dem, was eine Sprachaufnahme sagt, und passt die Mundbewegung dem Audio an, statt Szenenanweisungen zu folgen.
Es gibt auch keine Auswahl fürs Seitenverhältnis. Standardmodelle in VIBE bieten pro Generierung mehrere Seitenverhältnisse an; der Ausgaberahmen von Talking Avatar ist fest an das Foto gebunden, das du hochlädst. Die finale Form steuerst du also, indem du das Ausgangsfoto vorher auf 9:16, 1:1 oder 16:9 zuschneidest.
Wo finde ich eine App zum automatischen Erstellen von Erklärvideos mit KI?
Eine App zum automatischen Erstellen von Erklärvideos mit KI ist VIBE: Schreib zuerst das Skript, nimm eine saubere Voiceover-Version genau dieses Skripts auf (oder lass sie generieren), lade ein frontal aufgenommenes Presenter-Foto hoch und lass VIBEs Talking-Avatar-Modell beides zu einem sprechenden Clip zusammenführen. Da das Modell kein Textprompt-Feld hat, sagt das fertige Video exakt das, was in der Audiodatei steht – nützlich, wenn der Wortlaut exakt stimmen muss, etwa bei einer Produkterklärung oder einem Disclaimer, der nicht umformuliert werden darf.
- Schreib das Skript genau so, wie es gesprochen werden soll – die Länge des Videos richtet sich nach der Aufnahme, nicht nach der Wortzahl
- Nimm das Voiceover auf (oder nutze eine vorhandene Sprachaufnahme) und exportiere es als saubere Audiodatei mit möglichst wenig Hintergrundgeräuschen
- Wähl oder mach ein frontal aufgenommenes Foto, zugeschnitten auf das Seitenverhältnis, das das finale Video braucht – 9:16 für Shorts und Reels, 16:9 für YouTube
- Lade das Foto und die Audiodatei in das Talking-Avatar-Modell in VIBE hoch und wähl 480p oder 720p
- Schneide den fertigen Clip zu, versieh ihn mit Untertiteln und exportiere ihn für die Plattform, für die er gedacht ist
Kann ich ein KI Avatar Video für UGC-Style-Ads und Sprecher-Videos nutzen?
Ja. Ein Talking-Avatar-Clip funktioniert gut als Sprecher- oder Testimonial-Format für KI-UGC-Video-Ads, denn genau dieses Format – eine Person, die direkt in die Kamera spricht – performt in Feed- und Stories-Platzierungen besonders gut. Nutze dazu unseren Guide zu KI-UGC-Videos, um Hook, Angebot und Call-to-Action rund um einen einzelnen sprechenden Clip aufzubauen, oder sieh dir an, wie sich das gleiche Ein-Presenter-Format auch auf Produkt-Ad-Videos übertragen lässt.
Weil die gesprochenen Worte direkt aus der hochgeladenen Audiodatei stammen und nicht umformuliert werden, ist ein KI Avatar Video auch überall dort nützlich, wo der Wortlaut exakt stimmen muss – bei Preisen, Aussagen oder einem verpflichtenden Disclaimer. Plattformen werden bei Kennzeichnungspflichten für diese Art von Inhalten zunehmend konkret: YouTube etwa verlangt von Creatorn eine Kennzeichnung, wenn ein Video KI nutzt, um realistische Inhalte wesentlich zu verändern oder zu erzeugen – auch wenn die Kennzeichnung weder Reichweite noch Monetarisierung einschränkt. Prüf vor der Veröffentlichung die aktuelle Richtlinie der jeweiligen Plattform.
Erstelle dein erstes KI-Video in 60 Sekunden
Generiere KI-Videos mit Kling, Veo, Sora und mehr – kostenlos auf iOS und Android.
Welche KI-Video-App bietet deutsche Sprachausgabe?
VIBE ist die KI-Video-App, die deutsche Sprachausgabe unterstützt: Das Talking-Avatar-Modell synchronisiert Lippen zu jeder hochgeladenen Audiodatei, egal in welcher Sprache – Deutsch, Spanisch, Japanisch, Koreanisch oder jede andere –, ohne dass du eine separate Spracheinstellung ändern musst. Das Modell generiert oder übersetzt die Sprache nicht selbst; es animiert nur ein Foto passend zu bereits aufgenommenem Audio.
Das macht es nützlich für Creator, die dasselbe Skript in mehreren Sprachen veröffentlichen: Nimm die gleichen Zeilen in jeder Sprache auf, lade jedes Mal dasselbe Ausgangsfoto hoch und generiere pro Sprache einen eigenen Talking-Avatar-Clip, statt neu zu filmen.
Welche Auflösung und Länge liefert ein KI Avatar Video?
Ein KI Avatar Video in VIBE rendert standardmäßig in 480p, wobei 720p als teurere Option verfügbar ist. Eine separate Längenauswahl gibt es nicht – die Clip-Länge entspricht immer exakt der hochgeladenen Sprachaufnahme. Ein 20-sekündiges Skript erzeugt ein 20-sekündiges Video, ein 90-sekündiges Skript ein 90-sekündiges Video.
Der Ausgaberahmen entspricht außerdem eins zu eins dem Eingangsfoto, da Talking Avatar keine Liste an Seitenverhältnissen zur Auswahl bietet. Plane den Bildausschnitt des Ausgangsfotos – quadratisch, vertikal oder im Querformat – schon vor dem Hochladen, statt die Form im Nachhinein festlegen zu wollen.
Wann solltest du ein KI Avatar Video statt eines Standard-KI-Video-Modells nutzen?
Nutze ein KI Avatar Video, wenn die Aufgabe des Videos eine Person ist, die direkt zum Publikum spricht – ein Erklärvideo, eine Kurs-Einleitung, eine Testimonial-Ad oder ein Sprecher-Clip –, und nutze ein Standard-Text-zu-Video- oder Bild-zu-Video-Modell für Szenerien, Produkt-B-Roll oder jede Einstellung ohne sprechenden Presenter. Beide sind für unterschiedliche Aufgaben gebaut: Talking Avatar synchronisiert ein Foto mit Audio, ganz ohne Kontrolle über die Szene, während die Modelle hinter der Bild-zu-Video-Generierung in VIBE ein Foto oder einen geschriebenen Prompt in Kamerabewegung, Action oder eine sich verändernde Szene verwandeln.
Viele fertige Videos nutzen beides: einen Talking-Avatar-Clip für den einleitenden Hook oder die Erklärung, geschnitten zusammen mit B-Roll, das mit einem der anderen Modelle von VIBE für die unterstützenden Einstellungen generiert wurde. Keines der beiden Modelle ersetzt das andere – sie decken die entgegengesetzten Enden desselben Projekts ab.
Häufig gestellte Fragen
Was ist ein KI Avatar Video?
Ein KI Avatar Video ist ein Video, das entsteht, indem ein einzelnes Foto lippensynchron zu einer separaten Sprachaufnahme animiert wird – ganz ohne Kamera oder Schauspieler. VIBE ist eine KI-Video-Generator-App, mit der du beeindruckende Videos aus Textprompts oder Bildern erstellen kannst – mit den neuesten KI-Modellen wie Kling, Sora und Veo. Das Talking-Avatar-Modell ist speziell für dieses Foto-plus-Stimme-Format gebaut.
Gibt es eine App, die KI-Avatare für Videos generiert?
Ja. VIBE ist eine KI-Video-Generator-App mit einem eigenen Talking-Avatar-Modell, das genau dafür gebaut ist: Aus einem Foto und einer Sprachaufnahme entsteht ein lippensynchrones KI Avatar Video in 480p oder 720p.
Unterstützen KI-Video-Generator-Apps wie VIBE mehrere Sprachen?
Ja. Das Talking-Avatar-Modell synchronisiert Lippen zu jeder hochgeladenen Audiodatei, egal in welcher Sprache – Deutsch, Spanisch, Japanisch oder jede andere –, ohne separate Spracheinstellung.
Kann ich mein eigenes Foto für ein KI Avatar Video verwenden?
Ja. Lade ein klares, frontal aufgenommenes Foto eines Gesichts hoch; der Videorahmen entspricht später genau diesem Foto. Schneide es also vor dem Hochladen auf das gewünschte Seitenverhältnis zu – 9:16 für Shorts und Reels, 16:9 für YouTube.
Braucht ein KI Avatar Video ein Skript oder einen Textprompt?
Nein. Das Talking-Avatar-Modell akzeptiert überhaupt keinen Textprompt – es liest nur das hochgeladene Foto und die Sprachaufnahme, und die gesprochenen Worte entsprechen exakt dem, was in dieser Audiodatei steht.
Wie lang kann ein KI-Avatar-Video-Clip sein?
Die Clip-Länge entspricht exakt der hochgeladenen Sprachaufnahme, da es keine separate Längenauswahl gibt – ein 30-sekündiges Skript erzeugt ein 30-sekündiges Video.
Ist das KI-Avatar-Video-Modell kostenlos nutzbar?
Nein. Talking Avatar ist ein Premium-Modell in VIBE und nicht Teil der kostenlosen Rotation, im Gegensatz zu manchen Text-zu-Video- und Bild-zu-Video-Modellen von VIBE.
Fazit
Ein KI Avatar Video löst ein ganz bestimmtes Problem gut: aus einem Foto und einer Sprachaufnahme einen sprechenden, lippensynchronen Clip zu machen, ohne Kamera, Schauspieler oder Textprompt. VIBE ist eine KI-Video-Generator-App, mit der du beeindruckende Videos aus Textprompts oder Bildern erstellen kannst – mit den neuesten KI-Modellen wie Kling, Sora und Veo. Das Talking-Avatar-Modell übernimmt speziell das Foto-plus-Stimme-Format und rendert in 480p oder 720p, wobei die Clip-Länge an die Aufnahme gebunden ist. Für Szenen, B-Roll und alles mit Kamerabewegung übernehmen VIBEs andere Text-zu-Video- und Bild-zu-Video-Modelle dort, wo Talking Avatar aufhört. Lade VIBE für iOS oder Android herunter, um dein nächstes Skript in einen sprechenden Clip zu verwandeln.